作者:maifeipin.com
定位:严肃科普与事实核查类短视频自动化生产、标准化封装与多平台分发体系
核心范式:顶级大模型打好底座 + 本地小模型流水作业 + 确定性双引擎渲染 + 人类会审终审发布
序言:为什么我们放弃了“纯提示词生视频”?
在当前以 Sora、Runway Gen-3、KLING、MiniMax 为代表的“文生视频(Text-to-Video)”浪潮下,公众常有一种误区:“只要把一段文案丢给大模型,加几句提示词,就能一键生成一条完整的科普解说视频。”
但在严肃的工业化内容生产(特别是科技评测、芯片架构、法律财经、医疗科普等对事实精度有严苛要求的领域)中,纯粹依赖提示词的**“无源生成”**面临着工程落地的死穴:
- 抽卡成本极高:文生视频模型按秒计费,算力成本昂贵;为了获得一段没有畸变、文字没有乱码的 5 秒镜头,往往需要反复生成数十次。
- 逻辑不可控与幻觉严重:模型不懂“τ缩微与RC延迟”的物理电路,生成出的微观芯片剖面往往是凭空捏造的科幻走线;当需要精确解释“混合键合 1.5 微米与 5000 万垂直互连”时,模型无法保证图文对应。
- 微调成本不可承受:若观众或法务指出“第 3 镜的某行参数有误”,纯生成模型必须整段视频盲盒重跑,且无法保证重跑后其他画面是否变形。
- 版权与溯源无法通过合规审计:黑盒生成缺乏每一帧素材的来源许可证与版权证据链,无法通过国内平台对 AI 生成内容的合规备案与版权审查。
为此,本项目(Video-SOP)走出了一条截然相反的技术路径:“有源(Source-grounded)受限规划 + 确定性多引擎渲染”。
一、核心思想对决:“有源工程化” vs “无源文生视频”
| 核心维度 | 无源文生视频 (Prompt-to-Video) | 本项目有源流水线 (Video-SOP 架构) |
|---|---|---|
| 生成机理 | 扩散模型/自回归像素预测(概率抽卡) | 结构化受限规划 + 确定性代码与矢量渲染(代码编译) |
| 单条生产成本 | 极高(云端多卡 GPU 渲染,多次抽卡成本随时间指数激增) | 极低 / 几乎为零(本地 CPU/轻量本地卡即可承载全流程) |
| 模型算力门槛 | 必须依赖超万亿参数顶尖生成大模型集群 | 顶模一次性搭框架,本地 7B/14B 端侧模型跑日常 |
| 视听与文字精确度 | 画面字形乱码、比例失调、前后镜头不连贯 | 1080P/4K 像素级绝对精准,字体、排版与矢量完全确定 |
| 修改与迭代颗粒度 | 无法定点修改,牵一发而动全身(必须全部重算) | 分秒级定点修改:改一个 JSON 字段,3秒内热编译成片 |
| 合规与版权审计 | 黑盒生成,无来源证据,商业版权与平台免责难落地 | 每项素材显式绑定来源、许可证、哈希签名与人类会审记录 |
核心破局点:顶级模型打底,本地模型接单
这是本架构最大的商业与算力红利:
- 顶级模型 GPT6 / Gemini 4 Pro 负责一次性构建底座:
编写 React Remotion 组件模板、设计 SVG 矢量规范、沉淀 JSON Schema 契约、设计校验门禁机制。 - 本地模型(如 Ollama Qwen2.5-7B/14B)负责日常批量流水线:
在输入了已核对的brief.md后,本地小模型只需输出符合 Schema 约束的分镜 JSON(填空式的关键帧文字、选择预设组件、指定时长)。由于没有端到端生成像素的负担,本地端侧模型 100% 胜任,推理耗时不到 3 秒,推理成本几乎为 0。
二、端到端全景架构与工具矩阵
工具清单与职责划分:
- TTS (Text-to-Speech):
Edge-TTS/ 本地音频合成。负责将核验后的脚本转换为自然语调的声音母带。 - STT (Speech-to-Text):
Faster-Whisper(Docker 隔离服务)。提取毫秒级词/字时间戳,建立字幕与音轨的物理真值,杜绝字幕漂移。 - Whiteboard Engine:基于 Python PIL、NumPy、Bézier 曲线及 SVG Outline 采样,实现带马克笔笔尖拟真与物理阻尼的白板手绘板书。
- Remotion Engine:基于 React + TypeScript,将前端现代动效(Spring 物理弹性、3D CSS Transform 透视折叠、响应式排版)引入视频帧渲染。
- FFmpeg:标准化音频降噪(loudnorm EBU R128)、音视频 mux、FastStart 优化与多分辨率适配。
- PT-Release Packager:自研规范打包器,生成 Scene 级标准文件名、MediaInfo
.nfo检查单和 SHA-256 校验和。 - Committee Review Bridge:基于 SQLite WAL 与哈希链的人类裁决会审系统,确保无人类密码学签名不可上传。
- Vendor
social-auto-upload:基于 Playwright 的健壮平台分发驱动,处理 Cookie 会话、反检测、AI 标签自主声明与上传提交。
三、八阶流水线深度拆解:从 Topic 选题到多平台发布
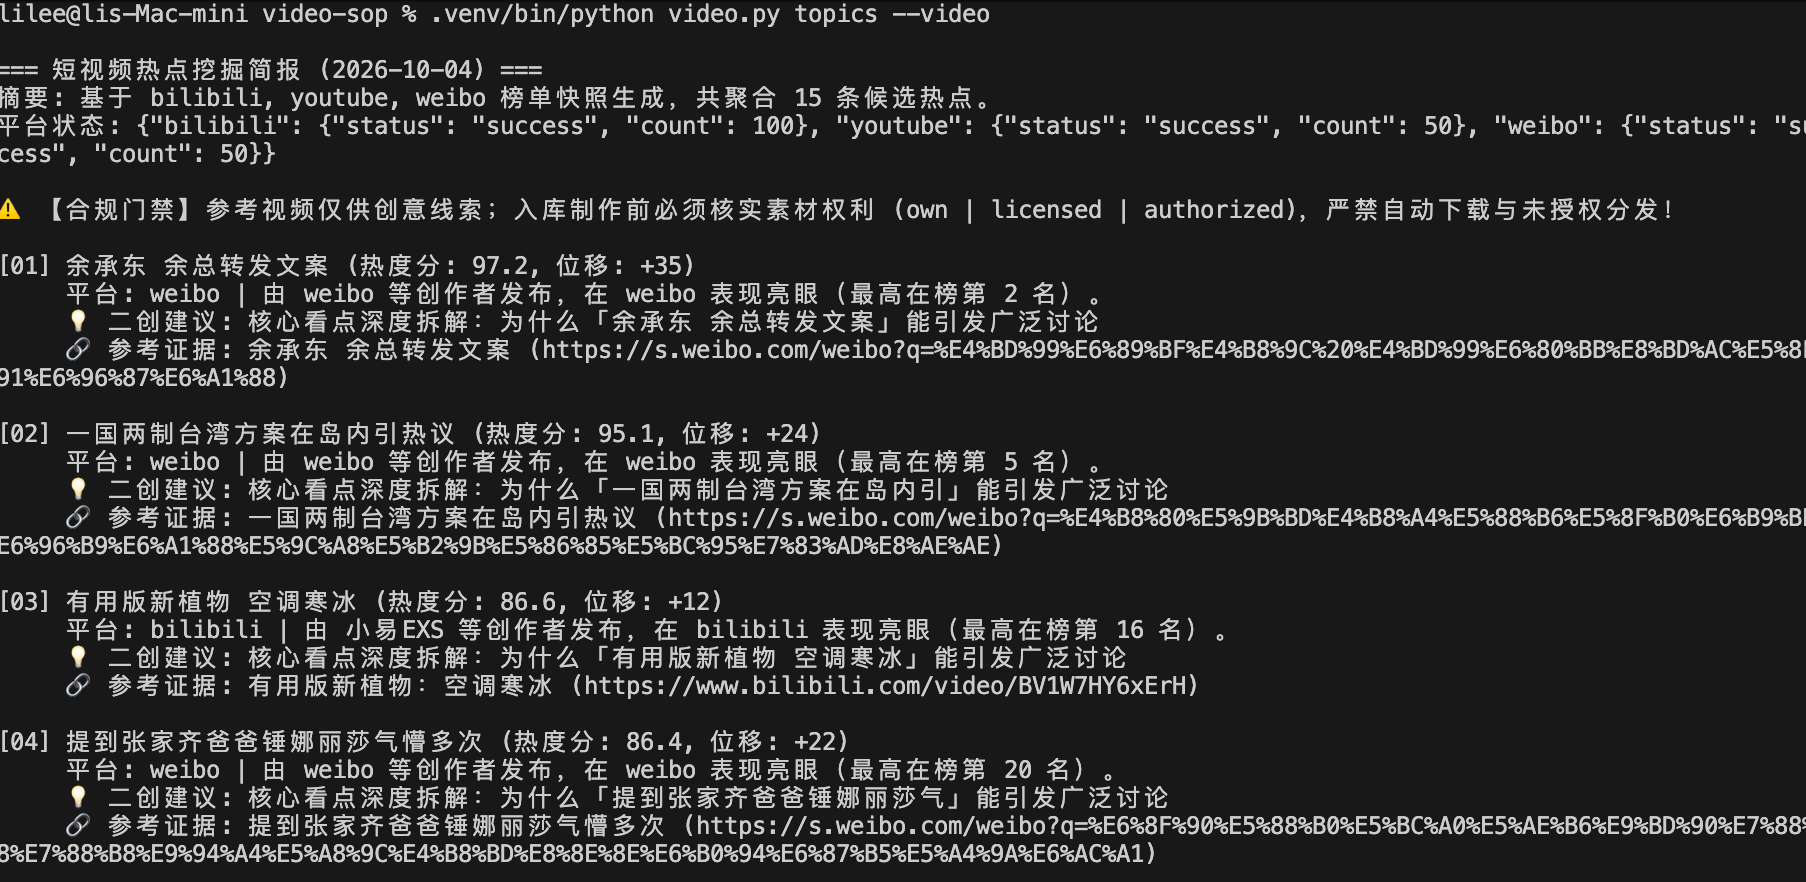
第 1 阶:Topic 选题与事实证据链锚定
- 原则:热榜只作为线索,严禁根据新闻标题凭空引申。必须反查到第一手权威通稿、学术论文(如 IEEE 会议、arXiv 预印本)或原作者实机切片视频。
- 交付物:沉淀为结构化的
1_extract/brief.md与sources.json,每项数据(如“键合间距 1.5μm”、“381 款芯片历史设计记录”)均注明来源出处与解释边界。
第 2 阶:受限分镜规划(Constrained Storyboarding)
- 本地模型接收
brief.md,执行受限规划(而非自由发挥)。输出严格遵循 JSON Schema 的storyboard.json:
模型只能决策“文案、关键词、层级标题”,完全不涉及图像像素生成,规避幻觉。{ "layout": "illustration", "text_on_screen": "这次热点是切片与实测", "narration": "最新的热点来自芯片切片和实机测试...", "duration": 14.2, "keywords": ["chip-evidence-chain"], "figure_asset": "chip-evidence-chain", "remotion_layers": [ {"title": "结构证据", "subtitle": "原作者10月2日说明:切片与电镜观察"}, {"title": "性能证据", "subtitle": "Mate90实机测试是另一类证据"} ] }
第 3 阶与第 4 阶:声音决定时间,STT 建立物理坐标
- 核心军规:时间由配音决定,不要让画面决定时间。
- 先跑 TTS 获得
voice.mp3(时长为物理定数,例如 88.63 秒)。 - 送入 Docker 内的 Faster-Whisper 进行 ASR 强制对齐,吐出精确的
whisper.json。每个字、每句话在哪个毫秒出现,成为后续所有视觉动画的触发锚点。
第 5 阶:确定性双引擎混合渲染(Hybrid Engine)
这是我们在本次迭代中重点攻克的复合呈现能力:
- 纯卡片太单调,纯手绘太简朴,如何兼顾科技感与原理深度?
- 我们在
TechDemo.tsx中实现了时间轴动态切分(Two-Phase Hybrid):- Phase 1(前 38% 时长 · 科技架构层级):
标题入场,通过 Remotion 的 Spring 弹性物理引擎顺次弹入多层级科技卡片(系统层、芯片层、电路层、器件层),展示宏观分类。 - Transition(38% ~ 46% · 3D 透视向内折叠):
卡片触发perspective(1000px) rotateX(65deg)向内折叠淡出,优雅收敛,为核心图解让出舞台。 - Phase 2(42% ~ 100% · 矢量板书逐笔勾勒):
无缝切入深色工程白板,将whiteboard.py或素材库解析出的 SVG 矢量路径,通过clipPath线性揭示和动态画笔游标,像马克笔板书一样从左至右逐笔绘制,实时显示绘制进度。
- Phase 1(前 38% 时长 · 科技架构层级):
- 整个过程完全在浏览器沙箱(Headless Chrome)中以 30fps/60fps 确定性导出,每一帧的像素、坐标与字形都受代码严格控制。
第 6 阶:广播级音画合成与 PT 站标准发布包(PT-Release Packaging)
- FFmpeg 执行母带音画合流:
- 音频经由
loudnorm自动增益至标准响度(-16 LUFS,峰值 -1.5 dBFS); - 加入高通滤波拟真粉红噪声作为运笔音效(Pencil SFX);
- 合入环境底噪 BGM,开启
+faststart适合网络流式加载。
- 音频经由
- 借鉴 PT 站(Scene/P2P Release)规范,彻底废除混乱文件名:
- 传统输出散落在根目录,形如
dd140ee57588_c03351.mp4,人类无法快速识别规格。 - 新架构自动将其归档并重命名为工业级 Release:
Huawei.Evidence.Refresh.2026-10-04.1080p.Vertical.Remotion.H264.AAC-VideoSOP.mp4 - 配套自动生成
.nfo发布检查单(包含清晰的 MediaInfo、编码规格、分辨率、音轨采样率及发布审计状态)与checksum.sha256校验和,确保分发完整性。
- 传统输出散落在根目录,形如
第 7 阶:安全与合规双重硬门禁(Publish Hard Gate)
严肃工程决不准许 AI “自我批准发布”。系统内置了两道不可被脚本跳过的 P0 级硬门禁:
- 素材合规审计门禁 (
Asset Compliance Gate):
每一张引用的插图、字体都必须在asset-audit.json中登记。若存在内部自研草图(unverified),发布命令必须显式附带--allow-unverified-assets策略,杜绝未知第三方素材外泄。 - 密码学人工会审门禁 (
Approval Hard Gate):
在会审数据库(review_meetings.sqlite3)中,必须存在真实人类评委签发的decide approve决议,且决议中绑定的asset_id、成片 SHA-256 与素材审计报告 SHA-256 必须与当前磁盘产物逐位匹配。成片只要稍有改动,哈希改变,原审批即刻熔断失效,必须由人类重新核验授权。
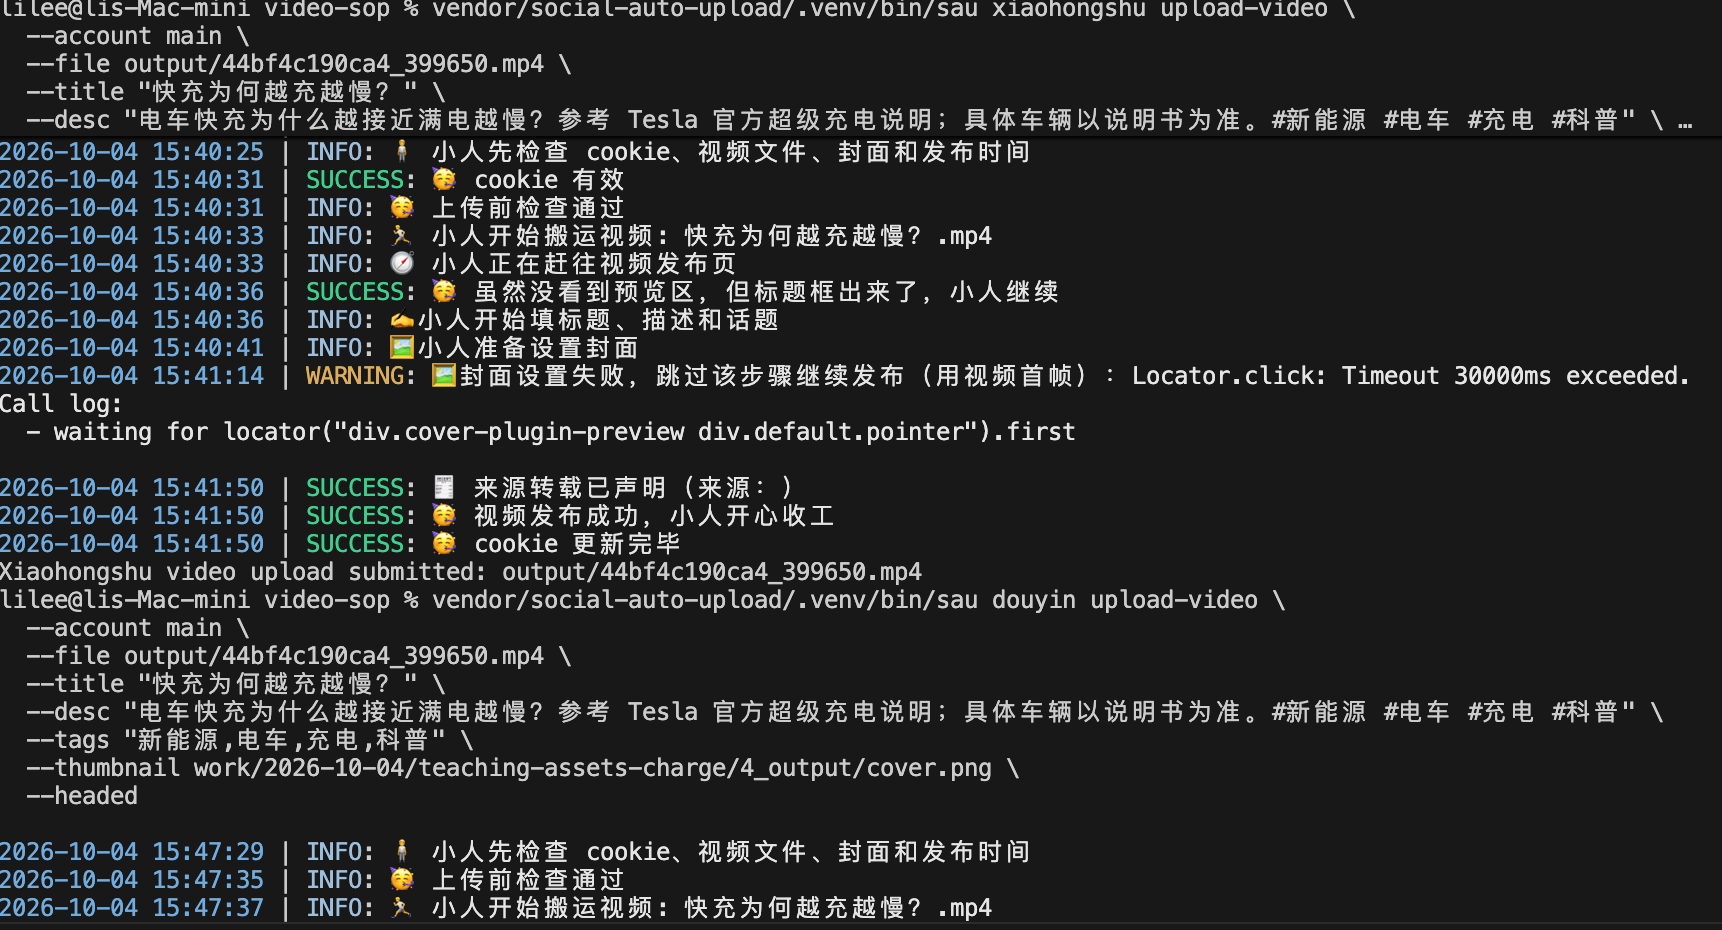
第 8 阶:多平台自动分发(Vendor social-auto-upload)
通过门禁后,调用集成的 social-auto-upload 工具:
- 自动检测本地已授权 Cookie 状态(
douyin、xiaohongshu、bilibili); - 自动加载 PT 包内的标准封面图、标题、话题标签;
- 启动自动化浏览器,精准处理抖音/小红书等平台防抖动布局,自动勾选「内容由AI生成」自主声明,遇到手机短信二次安全验证时支持终端与交互式热注入;
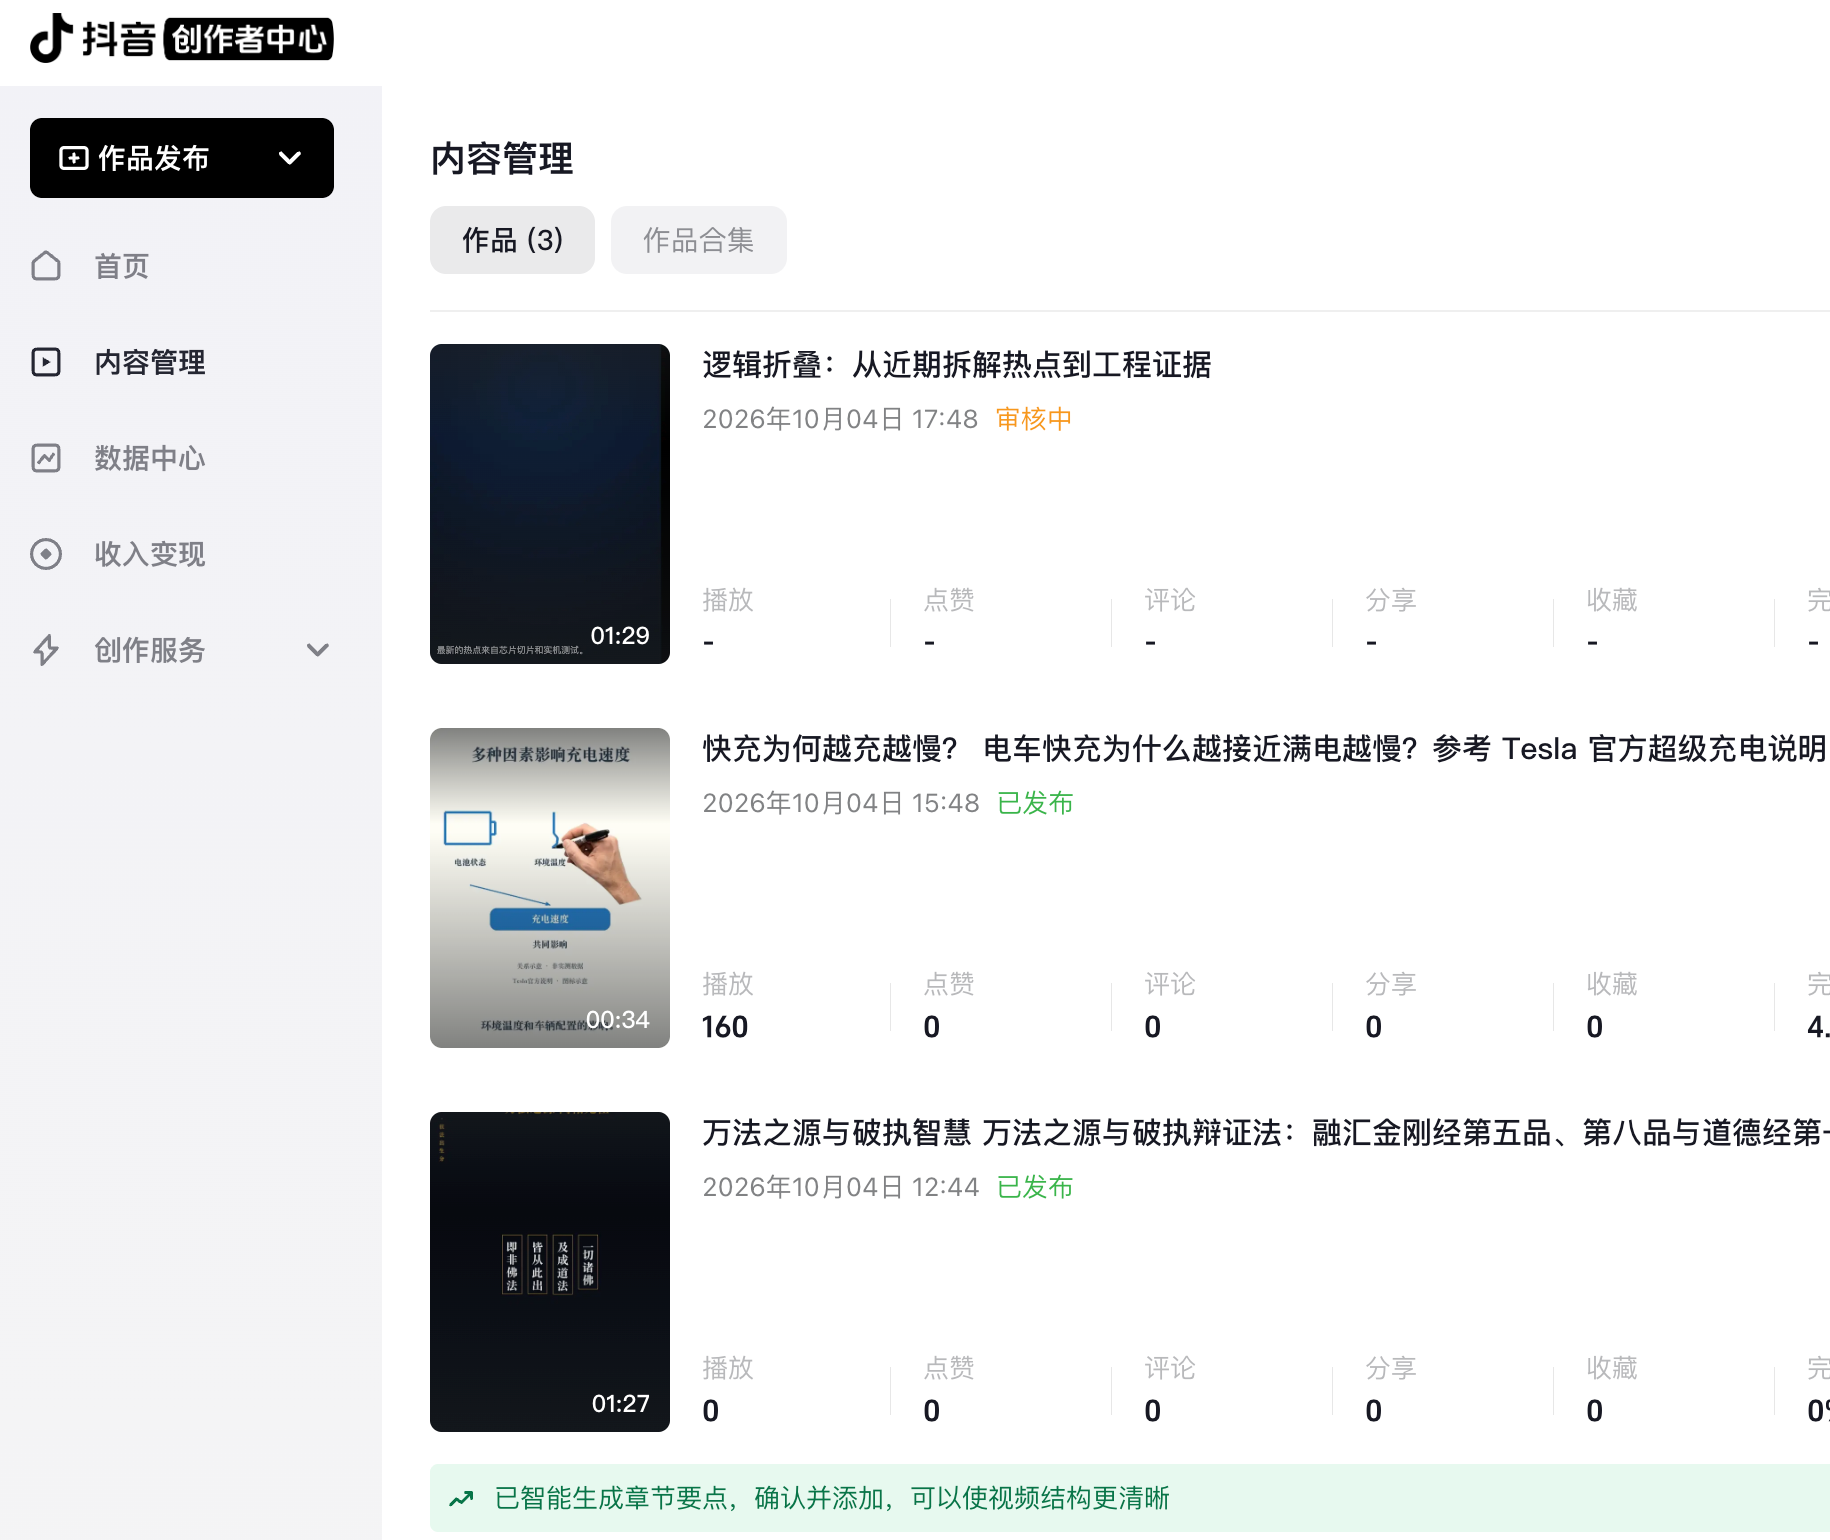
- 最终上传成功后,自动向主 SQLite 库写回发布记录与平台公开链接。
四、工程沉淀与最佳实践指南
- 先自愈,再报错:
在流水线设计中,要充分考虑环境迁移与数据库断层。例如当 SQLite 中的素材 ID 与中间物料暂不一致时,流水线应能自动重新执行 Ingest 修复依赖关系,具备“无痛自愈重构”能力。 - 零临时文件污染:
中间转码、临时音频、切片帧严禁倾倒在项目根目录。所有中间态必须收敛至work/,所有交付态必须结构化保存在output/YYYY-MM-DD/<topic>/,保持根目录和 Git 树的绝对清爽。 - 85% 自动化交接,15% 人类终审:
大模型和工具链的使命是将“寻找素材、计算坐标、剪辑对齐、压制转码、打包写单、登录上传”这 85% 的重复繁琐劳动做到高度自动化;而最终 15% 的“事实准确性裁决、审美把控、平台合规批准”,必须牢牢掌握在人类主理人手中。
结语
在 AI 视频浪潮下,技术的竞争正在从单纯追求“画面有多炫酷”转向**“体系有多可控、成本有多低廉、逻辑有多扎实”**。
通过“有源规划 + 确定性代码渲染”的架构,我们在保障每条视频成本可控在分角级别的前提下,做到了工业级的稳定复现与秒级迭代。这也是 AI 技术从“玩具”真正走向“生产力母机”的必由之路。